安寧香 · SYSTEM ARCHITECTURE
안녕향 시스템 아키텍처
실제 구동하는 경량 5단계 엔진과 사용자 흐름을 정직하게 한 장에 담은 문서. 출처: ADR-001 (model-architecture.md, 2026-06-28) — 연구팀 6인 독립감사 확정본.
아래는 실제 배포 구성이다. 모든 박스는 코드·인프라로 실재한다(가상 컴포넌트 없음). 이 중 추론 엔진 내부의 요청 처리 순서가 아래 섹션 1.1의 5단계 파이프라인이다.
server.js가 요청을 받아 recommender.js(오케스트레이터)로 넘기고, 엔진은 data/의 KB(SSOT)를 읽어 결정론적으로 배합·안전검사한다. LLM(llm.js)은 증상 분류에만 쓰이며 Gemma → Claude CLI → 키워드로 폴백한다.
각 STEP의 함수명은 실제 코드에 있는 이름입니다. STEP 1·5가 핵심 AI(생성형), STEP 4가 안전 계층입니다.
-
STEP 1 핵심 AI
classifyLLM()LLM 증상 multi-label 분류사용자가 자유 한국어로 입력한 증상 발화를 생성형 LLM이 읽고, 해당되는 질병 레이블을 복수로 동시에 산출합니다. 모델 우선순위:
Gemma→Claude CLI→ 키워드 폴백. 폴백까지 포함해 모든 환경에서 분류가 가능합니다.입력: 자유 발화 텍스트 → 출력: 질병 multi-label 분포 (D01~D10 중 해당) -
STEP 2 분별
screenSymptom()분별 질문 / 스크리닝분류가 모호하거나 안전에 영향을 줄 수 있는 동반증상이 의심될 때 사용자에게 되묻는 단계입니다. 안전 분기(특정 증상 조합 시 전문의 연계 권고)와 동반증상 확인이 여기에서 처리됩니다.
입력: STEP 1 레이블 + 추가 문진 → 출력: 정제된 질병 레이블 -
STEP 3 배합
aggregateScents()결정론적 가중 교차배합학습이나 역전파 없이,
scent-mapping.json의recommended_scents[].weight × evidence_strength를 직접 곱해 향 점수를 계산합니다. 상위 2~3종을 선택해 배합 비율을 산출합니다. 이 연산은 행렬 곱처럼 기술할 수 있지만 표현학습이 아닌 결정론적 가중합입니다.입력: 정제된 질병 레이블 → 출력: 향 2~3종 + 배합 비율 -
STEP 4 안전
analyzeBlend()안전 4종 룰 검사배합 결과를 실제 안내하기 전에 4가지 안전 기준으로 검증합니다. ① 성분 상한 초과 (캡), ② 독성 성분 포함 여부, ③ 노트 불균형(상위·중위·하위 노트 구성), ④ 누적 성분 과다(멘톨·1,8-시네올 등). 위반 시 경고 또는 차단합니다.
입력: 향 배합 → 출력: 통과 / 경고 / 차단 + 사유 -
STEP 5 핵심 AI
composePrescriptionRAG()근거 인용 RAG 큐레이션 합성안전 검사를 통과한 배합을 바탕으로 생성형 AI가 근거 문헌을 인용하면서 큐레이션 안내문을 작성합니다. 각 매칭 향은 어떤 임상 근거(evidence_id)에서 왔는지 역추적되며, 제품명은
BIO-FORMULA코드명으로 마스킹됩니다. 이것이 "지식그래프 기반 근거추적"의 실제 구현입니다.입력: 안전 통과 배합 + 근거 ID → 출력: 큐레이션 안내문 (코드명 마스킹 포함)
과장 없이, 실재하는 것과 쓰지 않는 것을 나란히 놓습니다.
classifyLLM()composePrescriptionRAG()= 과적합 확정
데이터 없음
수만 필요
불필요
아래 수치는 모두 scent-mapping.json에서 계산됩니다. 이 파일이 데이터 SSOT입니다.
HIRA TOP 10 노인 정신건강 다빈도 질환. 각 질병에 임상 근거 향과 전통 향이 연결됩니다.
임상 티어 S01–S14(매칭 배합 구동), 전통 티어 S15–S24(동의보감 서사, 배합 미참여).
각 향의 핵심 화합물(GC-MS 함량 범위). 안전 계층(STEP 4)의 성분 상한 계산에 직접 사용됩니다.
E01–E36(임상 24 + 전통 12). 각 큐레이션 안내는 여기에 연결된 evidence_id까지 역추적됩니다. 이것이 "근거추적 데이터 자산"의 실체입니다.
아래 이미지는 학습된 모델 임베딩이 아니라, 큐레이션된 지식베이스(scent-mapping.json)의 화학적 구조를 분석한 것입니다. PCA는 여러 분석 방법 중 하나입니다.
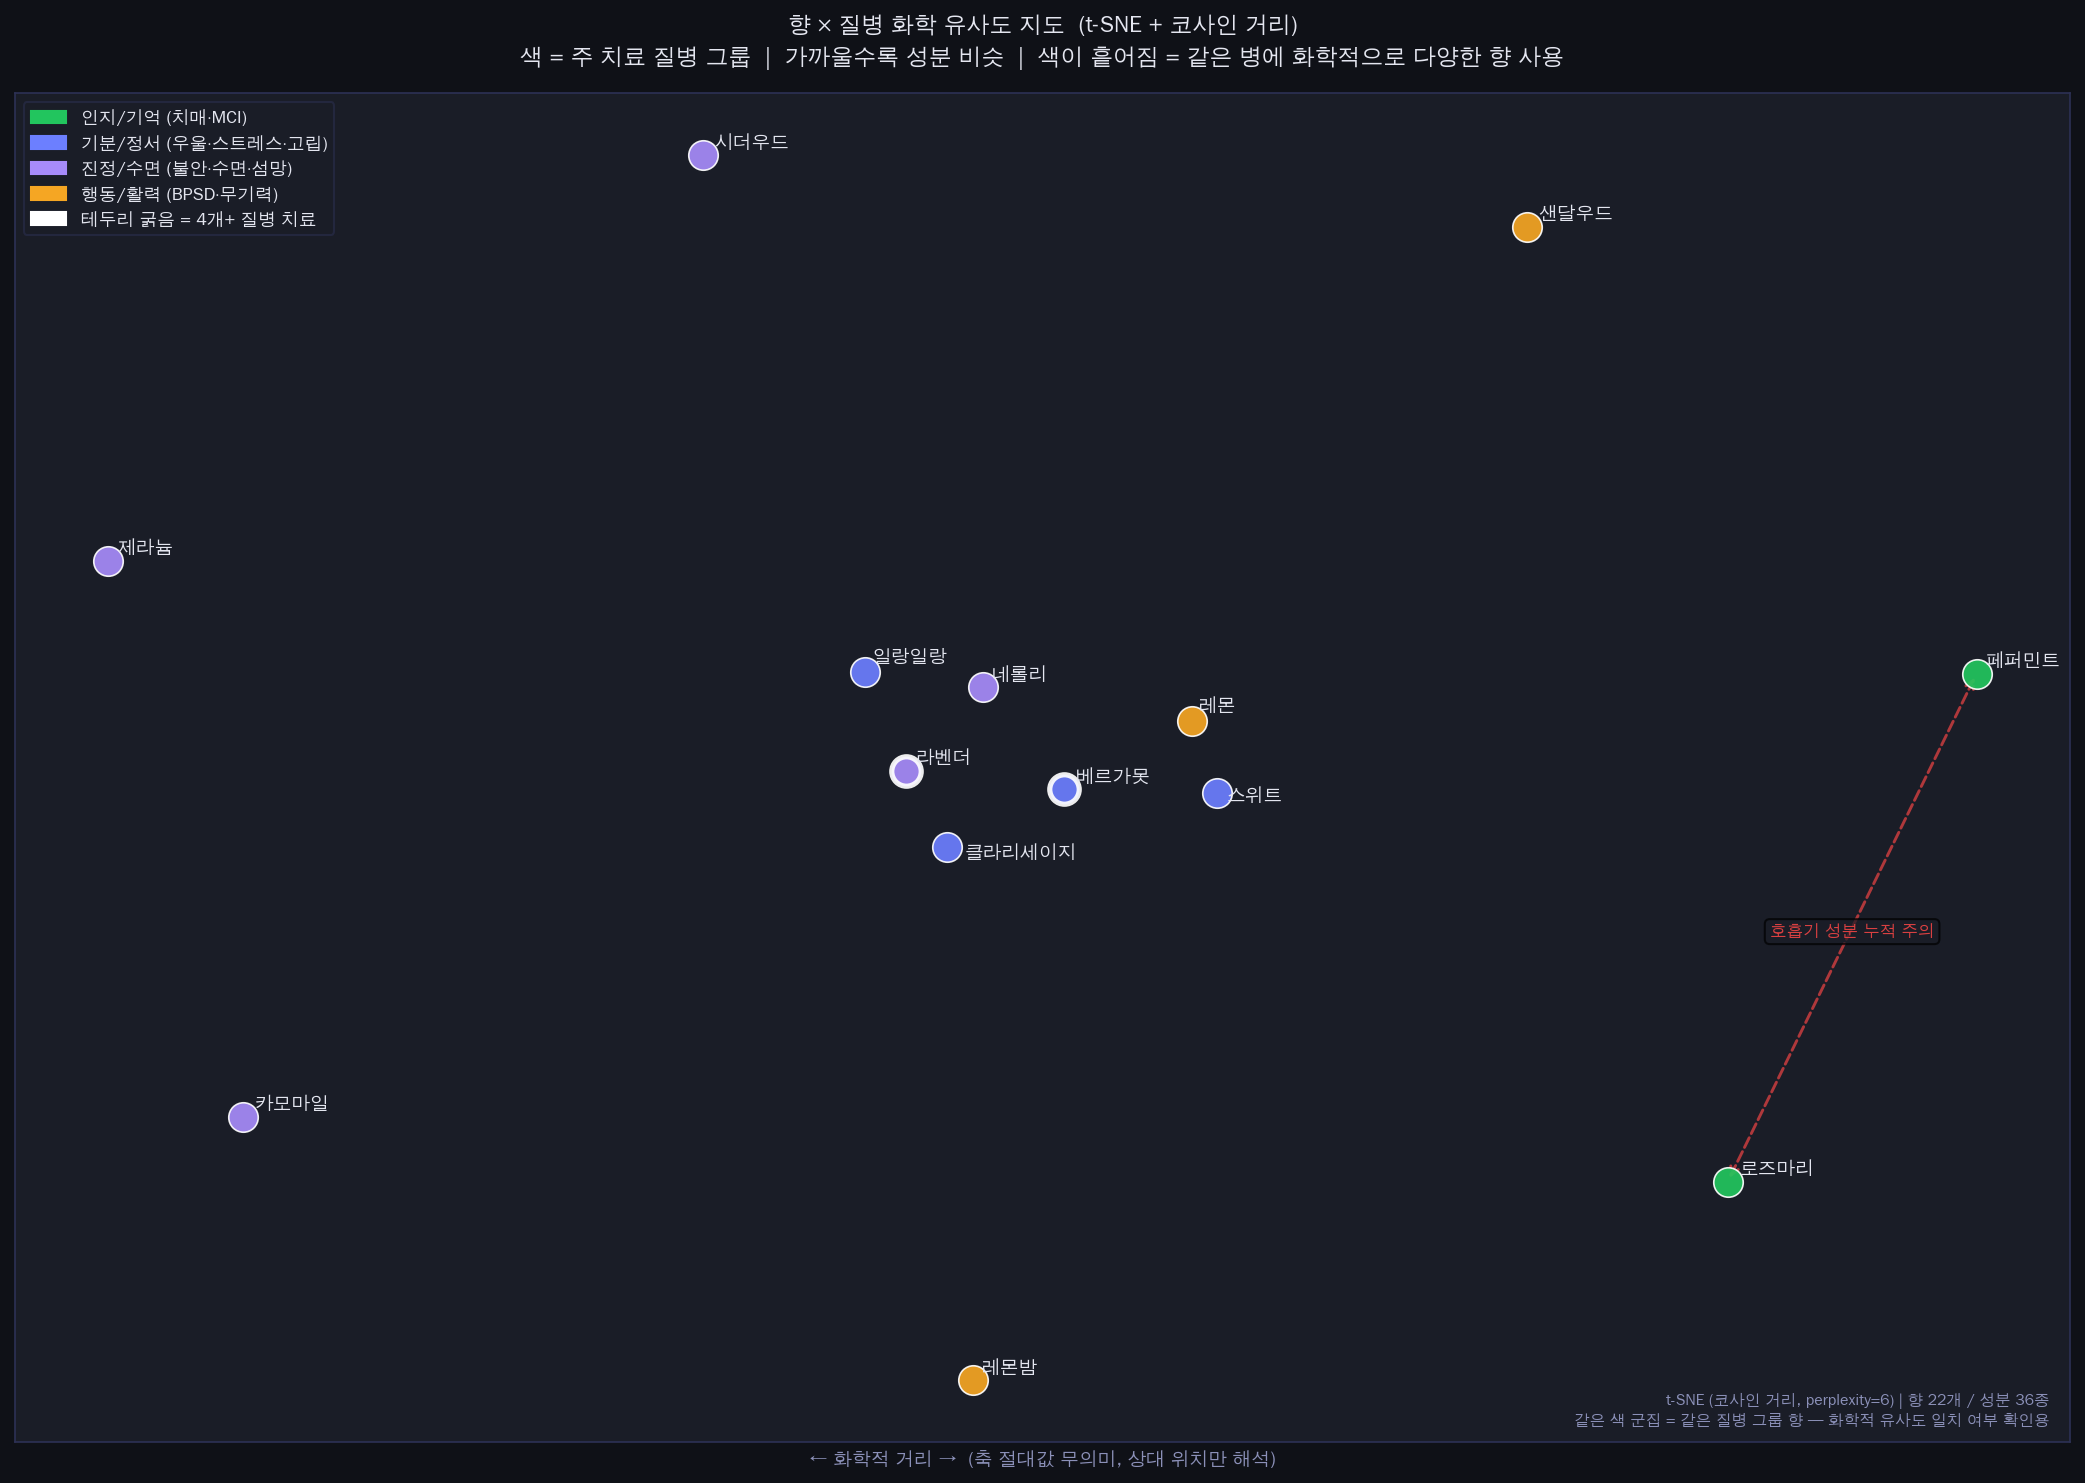
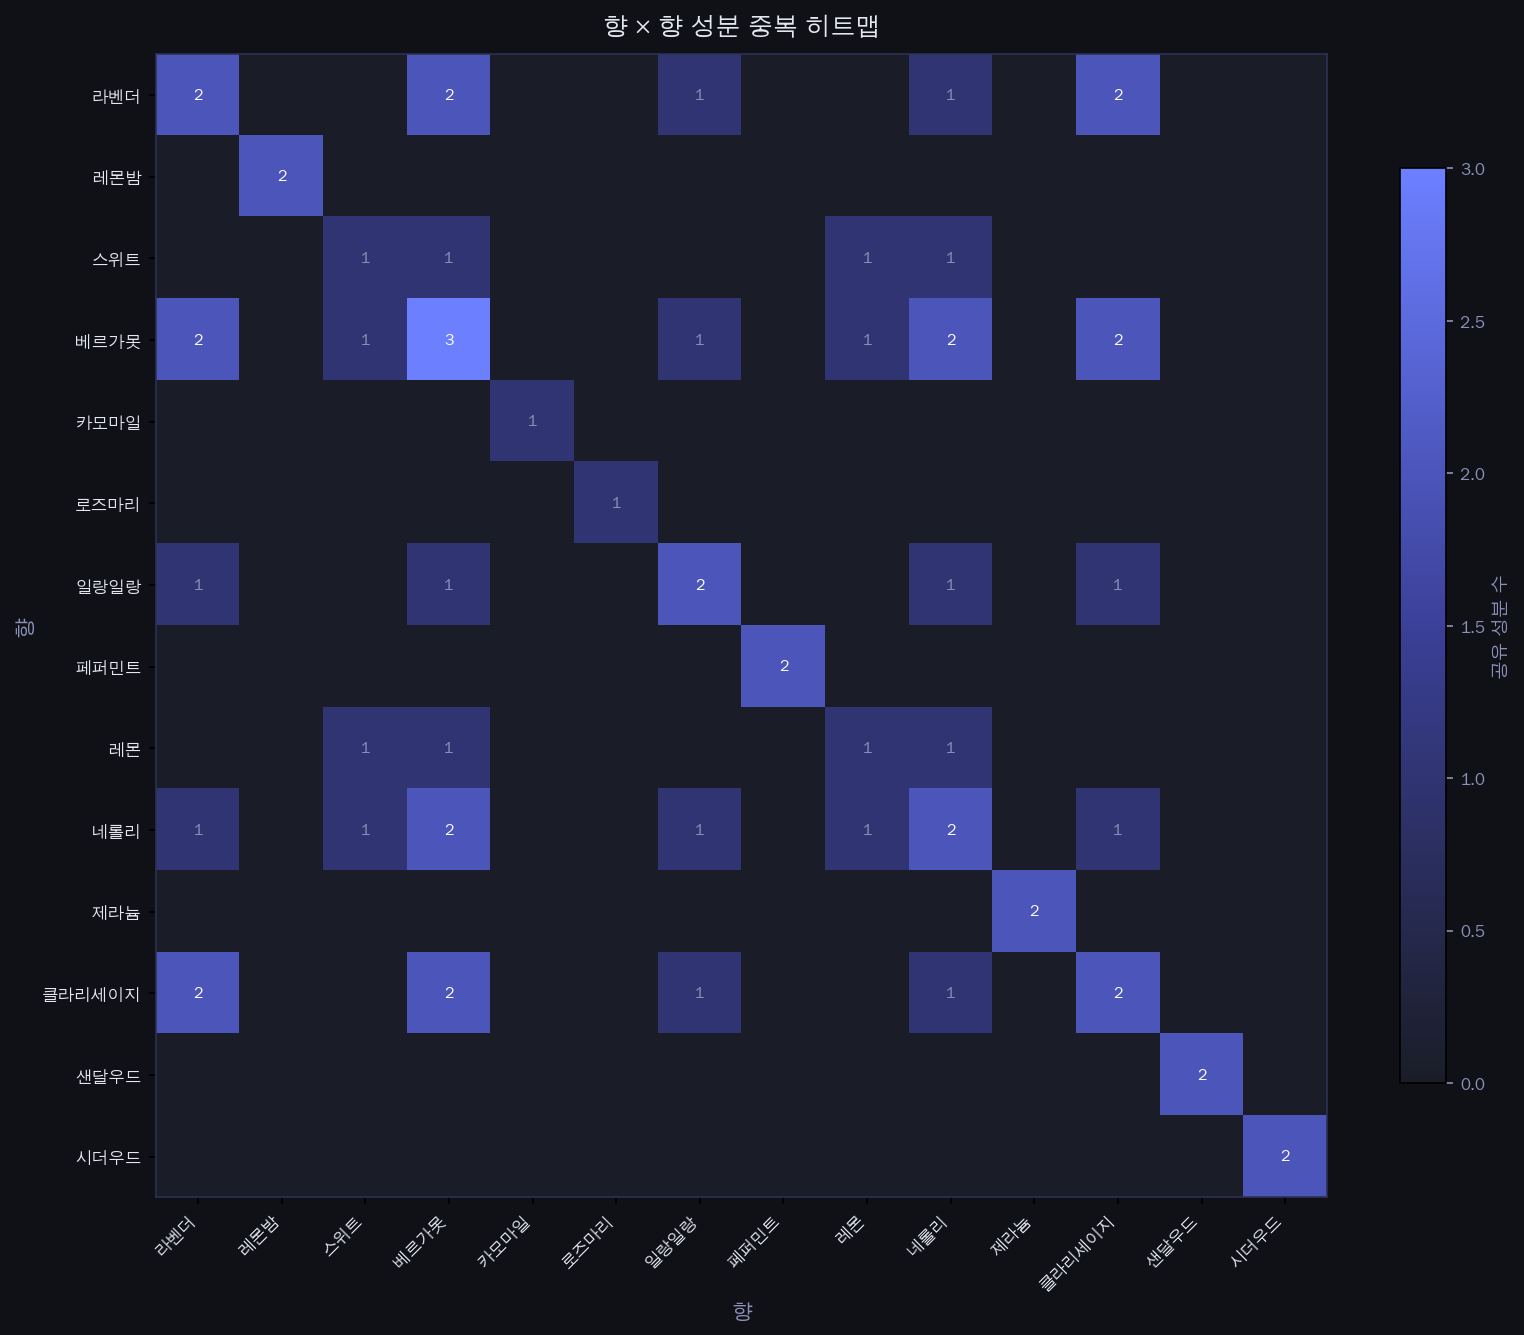
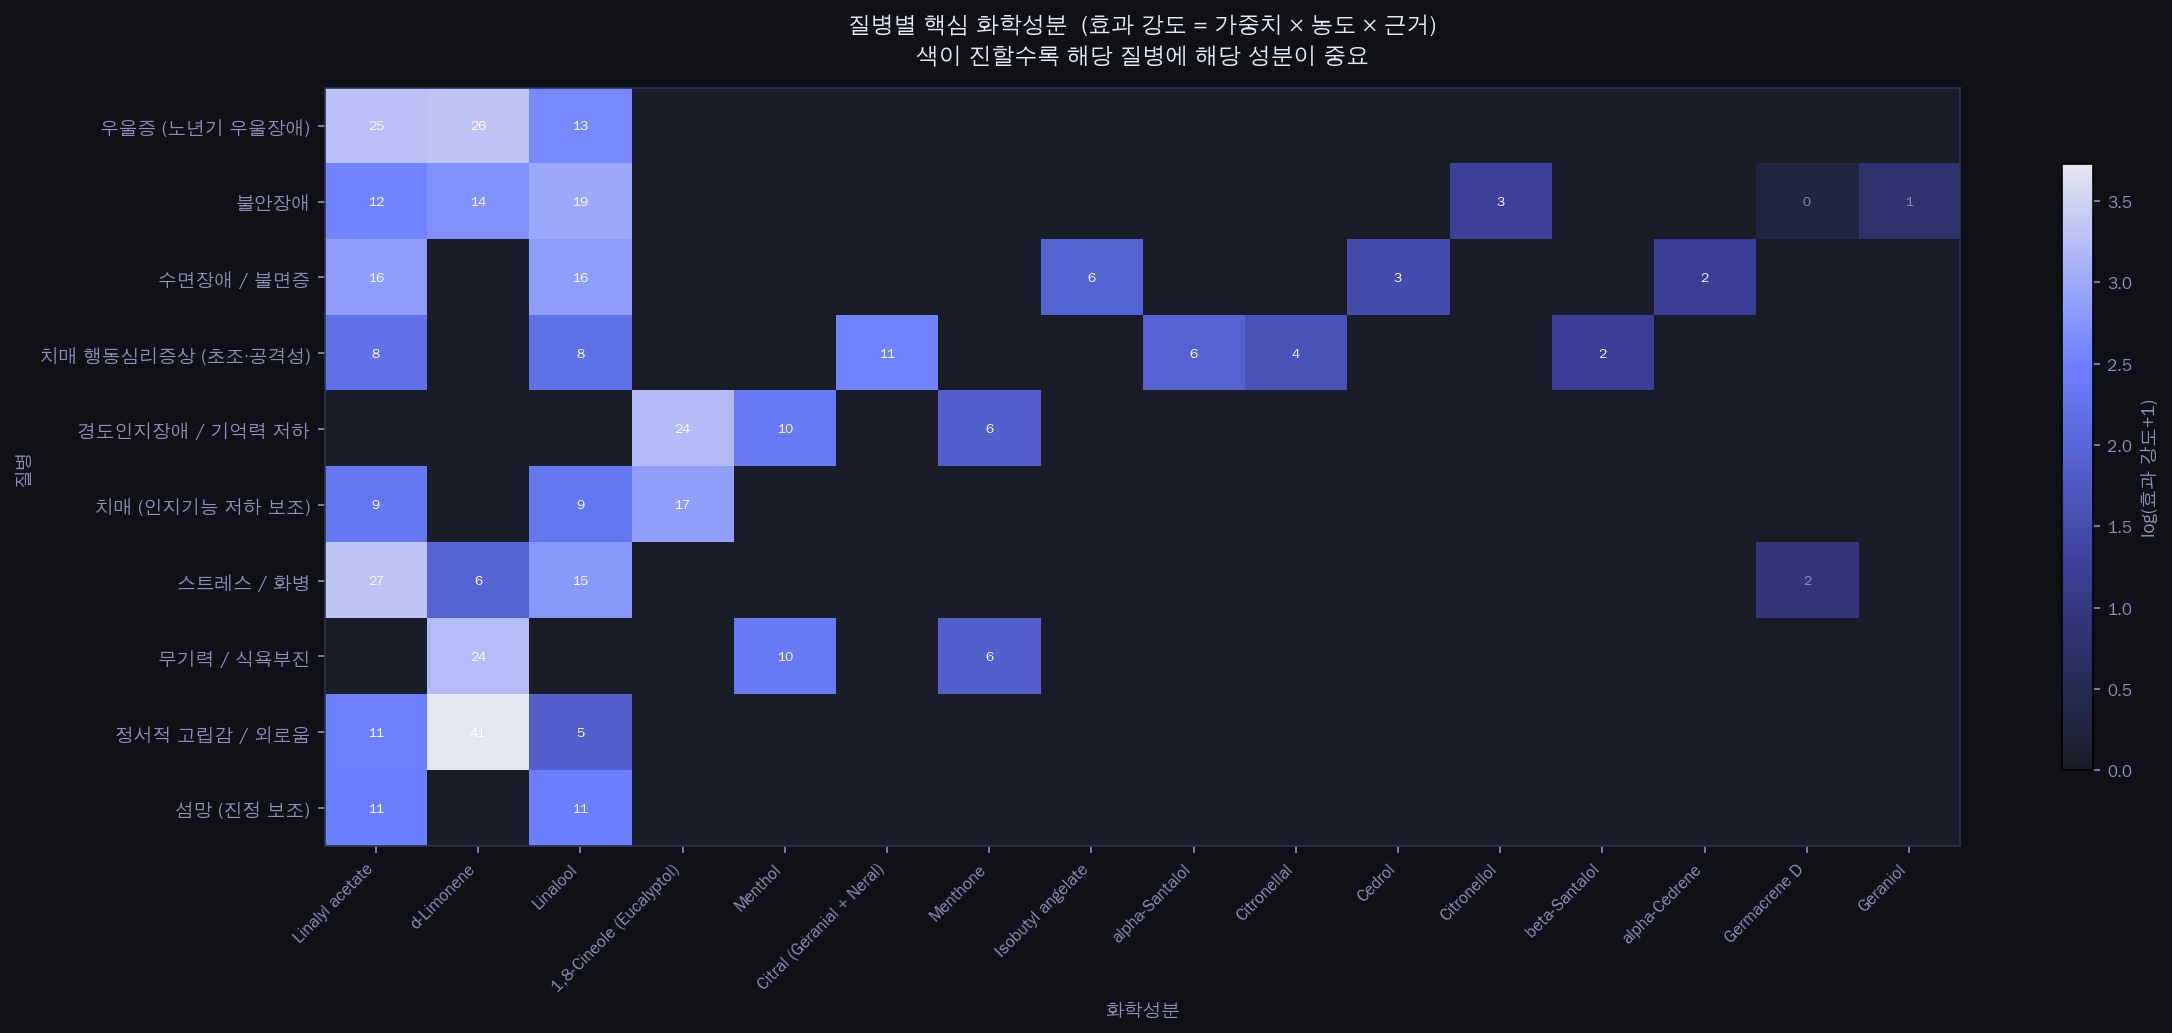
중량기법은 잘못된 것이 아니라 지금 데이터에서 발동 조건을 충족하지 못한 것입니다. 진입 임계를 명시하고 잠금 상태로 둡니다. 임계 미달 기간 동안 코드·설명 어디에도 "구동 중"으로 표기하지 않습니다.
| 잠긴 기법 | 진입 임계 (발동 조건) | 현재 | 판정 |
|---|---|---|---|
| 증상 인코더 fine-tune KLUE-RoBERTa 등 |
자체 라벨링 발화 ≥ 5,000건 | ~0건 | 잠금 |
| Learning-to-Rank 매칭 | 피드백 라벨 ≥ 수천건 | ~0건 | 잠금 |
R-GCN / ComplEx / KGE |
triple ≥ 수만개 | 엣지 53개 | 사실상 영구 잠금 |
ChemBERTa 독성 분류기 |
위 KGE 선행 + 성분 라벨 충분 | — | 잠금 |
pgvector 의미 검색 |
KB가 RAG 룰 조회로 불충분해질 규모 | 불필요 | 잠금 |
잠금 로드맵의 1순위 해제 경로: 자체 발화 라벨링(≥ 5,000건)이 쌓이면 증상 인코더(STEP 1) fine-tune이 가장 먼저 가능해집니다.
현재 엔진은 자체 KB(scent-mapping.json)만 직접 구동합니다. 아래 외부 데이터는 KB 구축의 참고 출처이거나 중량기법 도입 시 필요한 리소스입니다.
| 출처 | 역할 | 라이선스 |
|---|---|---|
|
FlavorDB2 IIIT-Delhi ⚠️ CC BY-NC-SA 3.0 — 상업 서비스에서의 직접 학습/사용 금지. 본격 단계 진입 전 별도 상업 라이선스 협의 또는 PubChem 대체 필요. |
성분 분자 정보 (KB 구축 참고 / 중량기법 도입 시) | 라이선스 주의 |
|
HIRA TOP 10 건강보험심사평가원 |
질병 10종 카테고리 선정 기준 (D01–D10) | 공공 |
|
PubMed / PMC E-utilities API |
임상 근거 24건(E01–E17, E30–E36) 출처. 향-증상 RCT·메타분석 논문. | 공공 |
| IFRA Standards + RIFM RIFM: 본격 단계 Elsevier 라이선스 계약 검토 필요. | 안전 룰 기준(STEP 4). 향료 알레르기 유발 성분 + 사용 제한 농도. | 회원/유료 |
프로세스 — AI가 향을 매칭하기까지
위 칸(청록 노드)은 사용자가 겪는 흐름, 가운데는 그걸 계산하는 엔진 코드, 아래는 엔진이 참고하는 근거 데이터입니다.
주황색 STEP 5(안전 검사)가 성분 과다·독성을 사전에 차단하는 단계이며, 엔진의 analyzeBlend()가 실행합니다.
사용자 6단계(체험)는 엔진 5단계(내부 계산)보다 한 단계 많습니다. 첫 번째 사용자 단계(증상 입력)는 사용자 행동이고 엔진 STEP 1이 그 결과물을 받아 처리합니다.
| 사용자 경험 단계 | 대응 엔진 함수 | 한 줄 설명 |
|---|---|---|
| STEP 1 · 증상 입력 | 사용자 행동 | 자유 한국어로 증상을 입력. 엔진이 받는 원시 입력. |
| STEP 2 · 질병 분류 | classifyLLM() |
LLM이 발화를 읽고 질병 multi-label 산출. 핵심 AI. |
| STEP 3 · 분별 질문 | screenSymptom() |
모호한 경우 되물어 질병 레이블 정제. |
| STEP 4 · 향 배합 | aggregateScents() |
결정론적 가중합으로 향 2~3종 + 비율 산출. |
| STEP 5 · 안전 검사 | analyzeBlend() |
4종 룰(캡·독성·노트·누적). 통과·경고·차단 판정. |
| STEP 6 · 큐레이션 안내 | composePrescriptionRAG() |
RAG로 근거를 인용하며 큐레이션 안내문 생성. 핵심 AI. |